Claude 进行计算机和浏览器使用的最佳实践
面向开发者的实用指南:如何基于 Claude 模型系列构建计算机和浏览器使用集成。
Claude 最新模型在计算机和浏览器使用能力上迈出了重要一步。借助这些能力,LLM 现在已经能够驱动越来越复杂的 Agent 系统,用来完成真实工作,例如构建软件应用,以及在多种彼此不同的技术之间自动化工作流。
在这篇博客中,我们分享 Claude 进行计算机和浏览器使用的最佳实践,内容从简单的配置调整到更高级的集成模式都有覆盖。希望这篇文章能帮助你开始把 Claude 的计算机和浏览器使用能力集成到自己的产品中。我们还发布了一个新的 demo 实现,它封装了其中一些最佳实践,并提供了一些额外工具,方便你基于 Claude 的计算机使用能力继续开发。
请注意,除非另有说明,这些建议适用于 Claude 4.6 系列(Opus 4.6、Sonnet 4.6、Haiku 4.5)以及 Claude Opus 4.7。如果 4.6 系列和 Opus 4.7 的指导建议不同,我们会在正文中直接指出。我们的结论基于内部实验,未来随着新模型和新技术出现,可能会更新。
入门:分辨率与缩放
点击准确性是任何计算机使用集成的基础。如果点击没有落在应该落的位置,后续的一切都无法正常工作:表单填不了,按钮按不到,工作流也会失败。影响最大的单项优化也非常简单:在把截图发送给 API 之前,先预先缩小截图。
确保正确缩放
当你把截图发送给 Claude 的 Computer Use API 时,模型会看到这张图,并在你指定的 display_width_px / display_height_px 坐标空间中返回点击坐标。但这里有一个重要限制:API 对图像尺寸有内部处理上限。超过这些上限的图片会在模型看到之前被缩小,这意味着模型是基于降质后的图片来判断点击位置,而你的执行框架却期望坐标对齐原始分辨率。
对于 Claude 4.6 模型系列,API 的限制是:
• 最长边最大值:1568 像素
• 总像素最大值:1.15 百万像素
• 超过任一限制的图片都会在内部被缩小
Opus 4.7 模型支持更高分辨率。限制是:
• 最长边最大值:2576 像素
• 总像素最大值:3.75 百万像素
当坐标空间和模型感知到的图片不一致时,模型预测的点击位置会落在与它实际看到的图片不同的显示尺度上。这是高分辨率下点击不准确的主要原因。修复方法很直接:在发送给 API 之前,始终把截图缩小到这些限制范围内。我们持续观察到,当图片超过限制时,准确率会明显下降;这个单项改动的价值超过几乎任何其他优化。
推荐分辨率
从 1280x720 开始。这是大多数用例中安全、实用的默认值。它大约使用 80% 的像素预算,同时远低于最长边和总像素限制,而且是模型在训练中见过的标准分辨率。它对现代 Web UI 和传统桌面应用都表现不错。
如果你使用 Opus 4.7,我们建议从 1080p 开始,因为相比 720p,它能带来有意义的质量提升,并在 token 使用量和性能之间取得较好平衡。
对于希望最大化模型接收视觉信息的开发者,我们也推荐一种“最大 API 适配”方案:根据源图像的原生宽高比,为每张图片计算最优分辨率:
import math # 4.6 系列为 1568,Opus 4.7 为 2576 MAX_LONG_EDGE = 1568 # 4.6 系列为 1.15MP,Opus 4.7 为 3.75MP MAX_PIXELS = 1_150_000 def compute_max_api_fit ( native_w, native_h ): """在保持宽高比的前提下,计算符合 API 限制的最大分辨率。""" aspect = native_w / native_h # 根据像素预算计算最大尺寸 h_from_pixels = math.sqrt(MAX_PIXELS / aspect) w_from_pixels = h_from_pixels * aspect # 应用最长边限制 if native_w >= native_h: w = min (w_from_pixels, MAX_LONG_EDGE) h = w / aspect else : h = min (h_from_pixels, MAX_LONG_EDGE) w = h * aspect # 不要放大到超过原始尺寸 w = min (w, native_w) h = min (h, native_h) return int (w), int (h)
这种方案稍微复杂一些,但能避免宽高比变形,并充分利用每张图片可用的像素预算。相比固定 1280x720,准确率提升不算巨大,但实现起来很直接,也能避免把 16:9 源图强行压到 4:3 显示分辨率时产生的变形。
应避免的分辨率:
• 原生分辨率(未缩放):除非你的源图刚好低于分辨率限制,否则发送原生分辨率截图是导致点击准确率差的最常见原因。
• 非常低的分辨率(低于 960x540):低分辨率图片会丢失太多细节,模型难以准确识别小型 UI 元素。
• 如果在 macOS 上:浏览器使用中一个常见问题是,macOS 上的截图通常以设备像素比 2 捕获,这意味着你得到的图片分辨率可能是屏幕坐标的 2 倍。
• 如果你使用 4.6 系列,应避免 1920x1080 及以上分辨率:这些会超过像素限制,并被静默缩小。在 Opus 4.7 上,上限更高(3.75 MP),所以 1080p 和 1440p 都在预算内;但仍然要避免不经缩放直接使用原生 4K。
坐标缩放
当你在发送前调整截图尺寸时,模型会在你指定的显示分辨率中返回点击坐标。执行点击前,你必须把这些坐标缩放回实际屏幕分辨率:
# 你的屏幕是 screen_w x screen_h # 你发送的截图被调整为 display_w x display_h scale_x = screen_w / display_w scale_y = screen_h / display_h screen_x = int (api_returned_x * scale_x) screen_y = int (api_returned_y * scale_y)
这很直接,但非常关键。因为如果你忘记缩放,或者 display_width_px / display_height_px 与你实际发送的图片尺寸不一致,每次点击都会稳定地产生偏移。
messages 数组中的内容顺序
构造 messages 的 content 数组时,请把文本指令放在图片之前,如下面的代码片段所示。这样模型在处理截图时就知道自己要找什么,从而提高点击准确性。
# 推荐:先放文本指令,再放截图: content = [ { "type" : "text" , "text" : "点击 Submit 按钮" }, { "type" : "image" , "source" : { "type" : "base64" , "media_type" : "image/png" , "data" : screenshot_b64}}, ] # 不推荐:先放图片,再放文本: content = [ { "type" : "image" , "source" : { "type" : "base64" , "media_type" : "image/png" , "data" : screenshot_b64}}, { "type" : "text" , "text" : "点击 Submit 按钮" }, ]
诊断点击问题
如果点击没有命中目标,通常可以归结为下面这些原因之一:
• display_width_px / display_height_px 与实际发送的图片尺寸不匹配
• 截图超过 API 限制,正在被静默缩小
• 内容顺序是图片在前,而不是文本在前
• 确保显示尺寸与你调整后的截图完全一致,而不是与你的原生分辨率一致
• 预先缩小到 1280x720,或使用 compute_max_api_fit
• 把文本指令移到 content 数组中图片之前
• 目标非常小(复选框、图标、开关)
• 源图分辨率非常高(4K+),缩小时丢失了细节
• 强行使用非原生宽高比导致宽高比变形
• 对密集 UI 启用 enable_zoom: True
• 在较低 DPI 下捕获,或先裁剪到相关屏幕区域再缩小
• 调整尺寸时保留源图宽高比
• 指令有歧义(例如页面上有多个类似提交按钮时,只说“点击 Submit”)
• 目标附近有视觉上相似的元素
• UI 太复杂,单条指令难以完成
• 使用更具体的 提示词,并加入位置上下文(例如“点击表单右下角的蓝色 Submit 按钮”)
• 把复杂交互拆成更小的步骤
• 提供更多关于页面布局的上下文
• 发送的截图超过了 API 限制
• 源图来自超高分辨率显示器(4K+),压缩比例极高
• 分辨率太低,丢失了关键细节
• 预先缩小所有截图,使其符合限制
• 对于 4K+ 源图,在 4.6 系列上,Sonnet 比 Opus 4.6 更能承受大幅缩小。到了 Opus 4.7,这个差距基本缩小了;请使用 4.7 的像素预算(最高 3.75 MP),这样一开始就不需要缩小太多。
• 先以 1280x720 作为基线;如果损失太大,再使用 compute_max_api_fit
点击任务的模型选择
根据我们的内部测试,Claude Sonnet 4.6 在点击的机械精度上通常更好(空间准确性更高,擦边未命中更少),而 Claude Opus 4.6 的推理能力更强。当源图需要大幅缩小时,Sonnet 4.6 也更稳健。
Opus 4.7 缩小了这个差距:通过测试,我们发现它的点击精度大致与 Sonnet 4.6 相当,而且它更高的分辨率预算减少了原本所需的缩小幅度。因此,当你希望同时获得 Opus 级推理能力和较强点击准确性时,它是一个很好的选择。
对于大多数任务,我们建议从 Sonnet 4.6 开始,它在点击准确性、推理能力和成本之间提供了最佳平衡。当你需要更强推理能力,尤其是使用高分辨率源图时,选择 Opus 4.7。如果延迟是优先目标,Haiku 4.5 仍然是很好的选择。高级工作流仍可能受益于 orchestrator + sub-Agent 模式:由推理模型负责规划和决策,而 Sonnet 或 Haiku 执行机械性的点击步骤。
处理小目标
目标越小,点击准确性越容易下降。大中型 UI 元素(按钮、输入框和标准菜单项)在安全分辨率范围内都比较可靠。真正的挑战来自小型和微型目标,例如复选框、系统托盘图标、下拉箭头、小开关,以及树状视图的展开/折叠按钮。
如果你的应用经常需要点击小目标,可以考虑这些策略:
对密集 UI 使用缩放。Claude 4.6 和 4.7 模型支持一种 zoom 能力,可以让模型在点击前以更高分辨率检查特定屏幕区域。在工具配置中启用它:
{ "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : 1280 , "display_height_px" : 720 , "enable_zoom" : True }
把目标做大。如果你能控制被自动化的 UI,增大点击目标的尺寸(哪怕只是适度增大)都会对可靠性产生非常明显的影响。这可能意味着使用更低的系统 DPI、放大浏览器,或调整 UI 缩放设置。
对极小目标使用键盘替代方案。对于非常小的元素,例如系统托盘图标或微型复选框,键盘快捷键或基于 Tab 的导航可能比点击更可靠。如果你的工作流允许,在特定步骤提示模型使用键盘交互,可以提高成功率。
考虑源图分辨率。来自 4K+ 显示器的截图如果被压缩到 720p,会丢失大量细节(例如,一个在 3840x2160 原生分辨率下为 16px 的复选框,在 1280x720 显示分辨率下大约只剩 5px,这会让目标变得更小,也更难命中)。如果你在处理非常高分辨率显示器,考虑使用 Opus 4.7,因为它比之前的模型有更高的分辨率限制。如果使用 4.6 模型,可以考虑以较低 DPI 捕获,使用显示缩放放大 UI 元素,或者只截取屏幕中相关部分,而不是整个显示器。由于这些模型需要用更少像素表示更多信息,我们观察到源图尺寸越大,性能越容易下降,这意味着需要更强的压缩。
我们测试过但没有帮助的方法
我们在内部评估中尝试了几种常见优化技巧,但没有发现这些方法带来稳定提升。不过,具体结果可能因场景而异:
• 把图片拆成更小的图块:把截图切成象限或区域分别发送,并没有提升点击准确性。
• 叠加带坐标的网格图案:在截图上添加可视化坐标网格,试图帮助模型定位目标,并没有产生可靠收益。
• 调整尺寸算法的选择:PIL LANCZOS、sips 和其他常见缩放算法产生的结果相同。使用你的技术栈里最方便的即可。
检查失败案例
如果在尝试上述修复后,模型行为仍然不可预测,请记录完整 transcript,并把预测点击位置叠加到源截图上,以理解模型实际看到了什么、做出了什么决策。
有些失败根本不是点击准确性问题。例如,某些下拉菜单可能会调用浏览器视口无法捕获的系统级 UI。看起来像是模型任务失败了,但实际上它根本看不到需要交互的菜单。在这类情况下,模型应该依赖替代方法,例如执行 JavaScript、键盘导航,或直接操作 document object model(DOM),而不是点击。
快速参考
如何为计算机使用缩放并准备图片
import math from PIL import Image import base64 import io # 4.6 系列使用 1568,Opus 4.7 使用 2576 MAX_LONG_EDGE = 1568 # 4.6 系列使用 1.15MP,Opus 4.7 使用 3.75MP MAX_PIXELS = 1_150_000 def prepare_screenshot ( screenshot: Image.Image, native_w: int , native_h: int ) -> tuple [ str , int , int ]: """调整截图大小以符合 API 限制,并返回 base64 和显示尺寸。""" # 方案 A:固定 720p(简单、可靠) display_w, display_h = 1280 , 720 # 方案 B:最大化适配 API(尽可能提高保真度) # display_w, display_h = compute_max_api_fit(native_w, native_h) resized = screenshot.resize((display_w, display_h), Image.LANCZOS) buffer = io.BytesIO() resized.save(buffer, format = "PNG" ) b64 = base64.standard_b64encode(buffer.getvalue()).decode() return b64, display_w, display_h def scale_coordinates ( api_x: int , api_y: int , display_w: int , display_h: int , screen_w: int , screen_h: int ) -> tuple [ int , int ]: """把 API 返回的坐标缩放回原生屏幕坐标空间。""" screen_x = int (api_x * (screen_w / display_w)) screen_y = int (api_y * (screen_h / display_h)) return screen_x, screen_y def compute_max_api_fit ( native_w: int , native_h: int ) -> tuple [ int , int ]: """在保持宽高比的前提下,计算符合 API 限制的最大分辨率。""" aspect = native_w / native_h h_from_pixels = math.sqrt(MAX_PIXELS / aspect) w_from_pixels = h_from_pixels * aspect if native_w >= native_h: w = min (w_from_pixels, MAX_LONG_EDGE) h = w / aspect else : h = min (h_from_pixels, MAX_LONG_EDGE) w = h * aspect w = min (w, native_w) h = min (h, native_h) return int (w), int (h)
用法:
import anthropic from PIL import Image client = anthropic.Anthropic() # 捕获截图(这里使用你自己的方法) screenshot = Image. open ( "screenshot.png" ) native_w, native_h = screenshot.size # 为 API 做准备 b64, display_w, display_h = prepare_screenshot(screenshot, native_w, native_h) # 发送给 Claude —— 文本放在图片之前 response = client.beta.messages.create( model= "claude-sonnet-4-6" , max_tokens= 4096 , betas=[ "computer-use-2025-11-24" ], messages=[{ "role" : "user" , "content" : [ { "type" : "text" , "text" : "点击 Submit 按钮" }, { "type" : "image" , "source" : { "type" : "base64" , "media_type" : "image/png" , "data" : b64}}, ] }], tools=[{ "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : display_w, "display_height_px" : display_h, }], ) # 把坐标缩放回实际执行所需的屏幕坐标 api_x, api_y = extract_click_coords(response) # 你的解析逻辑 screen_x, screen_y = scale_coordinates(api_x, api_y, display_w, display_h, native_w, native_h)
为 computer use 调整思考力度
Claude 的最新模型支持 adaptive thinking,这个设置可以让 Claude 在行动前自行决定要花多少精力推理中间步骤。你不需要手动设置 thinking token 预算,adaptive thinking 会让 Claude 根据每个请求的复杂度,动态决定何时以及使用多少 extended thinking。对于 computer use 来说,这意味着 Claude 可以思考自己在屏幕上看到的内容,规划多步交互,并在真正点击或按键前自我修正。
使用 adaptive thinking 时,Claude 的思考深度通过 thinking 参数中的 effort 级别控制:low、medium、high、xhigh(Opus 4.7 支持)以及 max。思考越多,每个动作的推理越充分,但也会带来更多输出 token、更高延迟和更高成本。
一个很自然的问题是:根据不同模型,computer use 到底用多少思考力度最合适?
Claude Opus 4.7
我们在一组端到端 UI 自动化任务上测试了每个 thinking effort 级别,任务覆盖桌面应用、浏览器和多应用工作流。
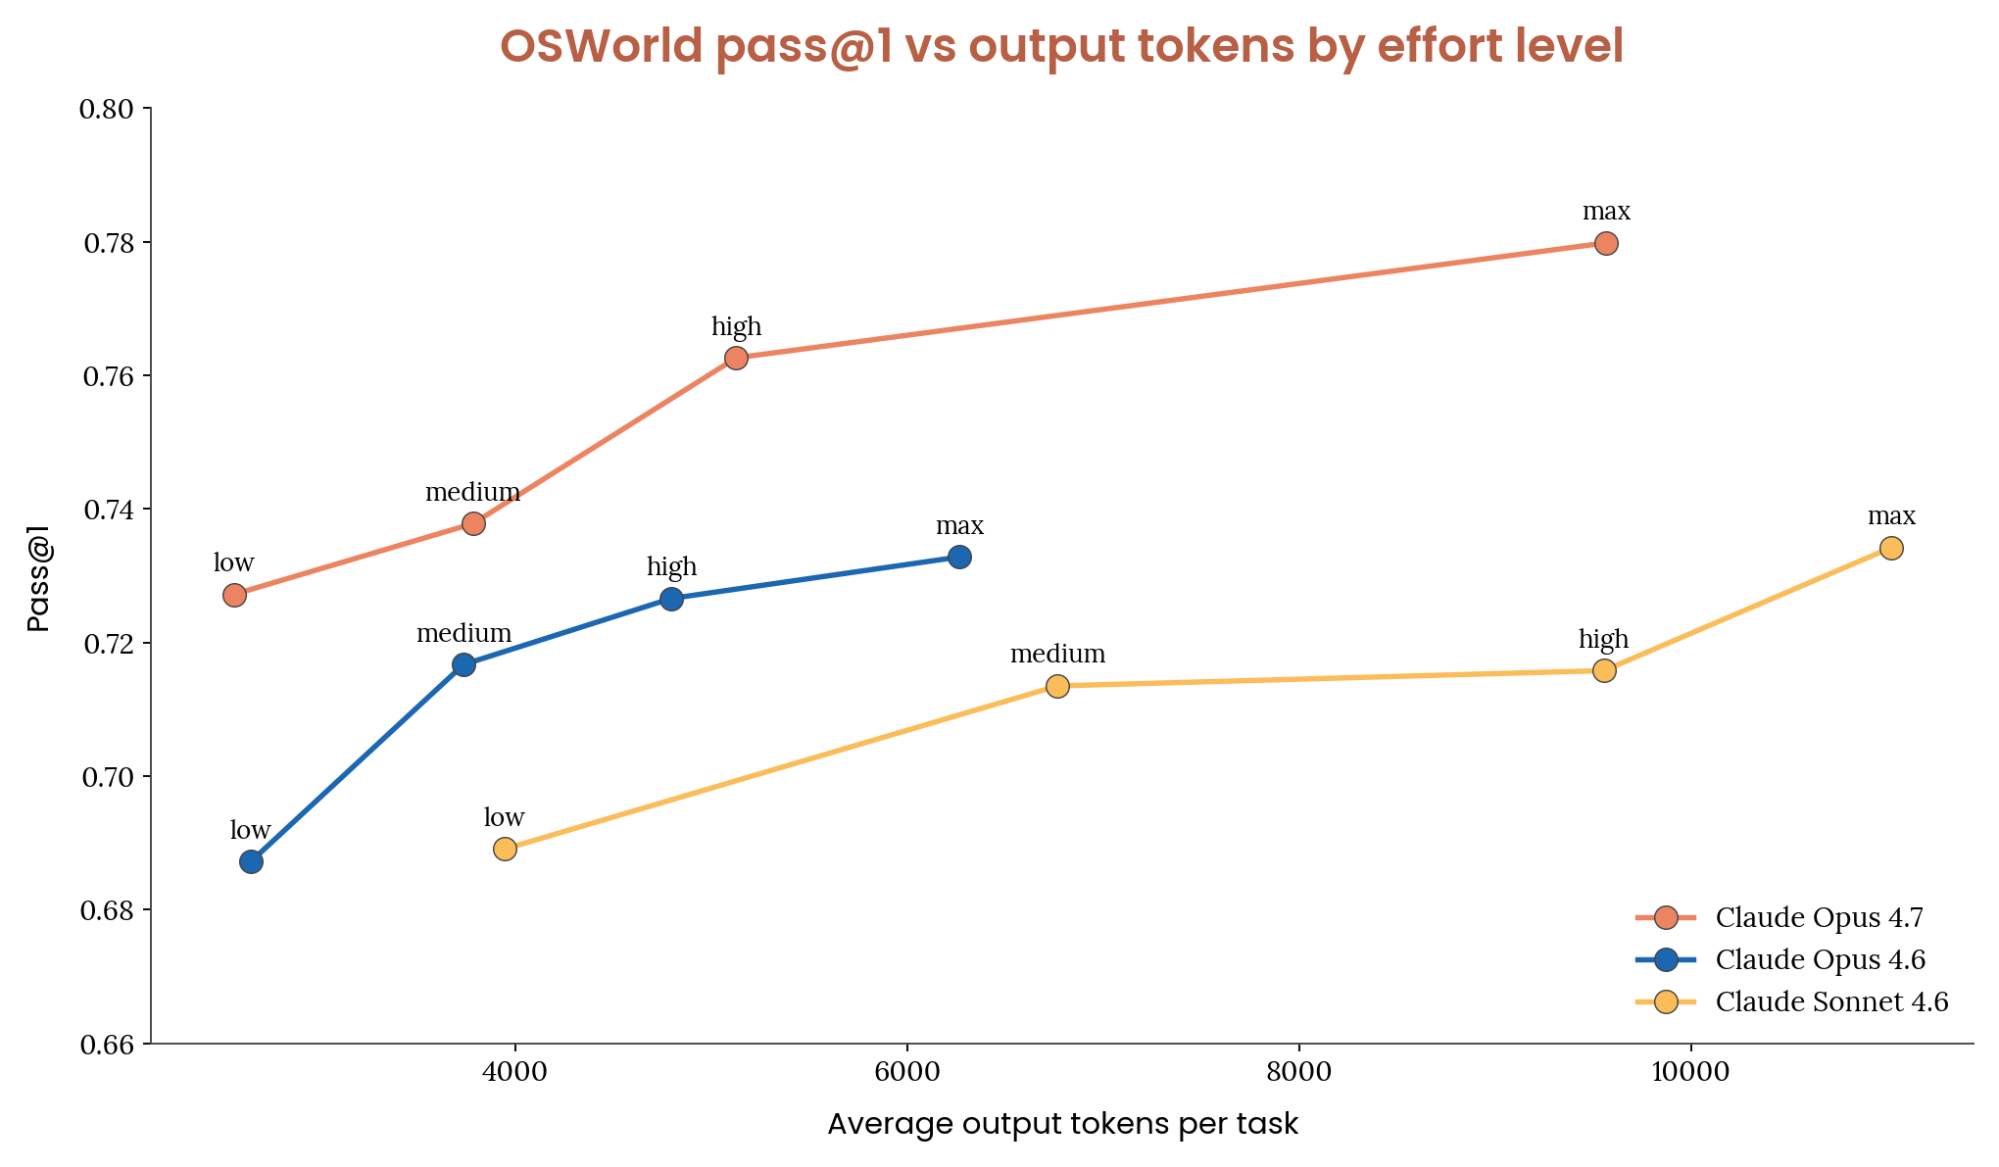
Opus 4.7 的表现优于 4.6 系列。在 OSWorld Verified 基准测试中,我们发现 Opus 在相同 token 用量和 effort 设置下,超过所有 4.6 系列模型。Opus 4.7 在 low effort 下的得分接近 Sonnet 4.6 的 max,同时每个任务只使用约 1/10 的 token。对于困难任务,Opus 4.7 是显而易见的选择。
把 effort 设置为 high,可以获得接近最高的任务成功率,同时输出 token 大约只有 max 的一半。与 Opus 4.6 相比,low、medium 和 high 使用的 token 量大致相同,但 OSWorld 分数都有提升。在我们的内部测试中,Max effort 使用更多 token,并取得了最佳分数。下面的表格概述了我们对各个 thinking effort 级别使用场景的建议。
effort 级别建议
Claude 4.6 模型
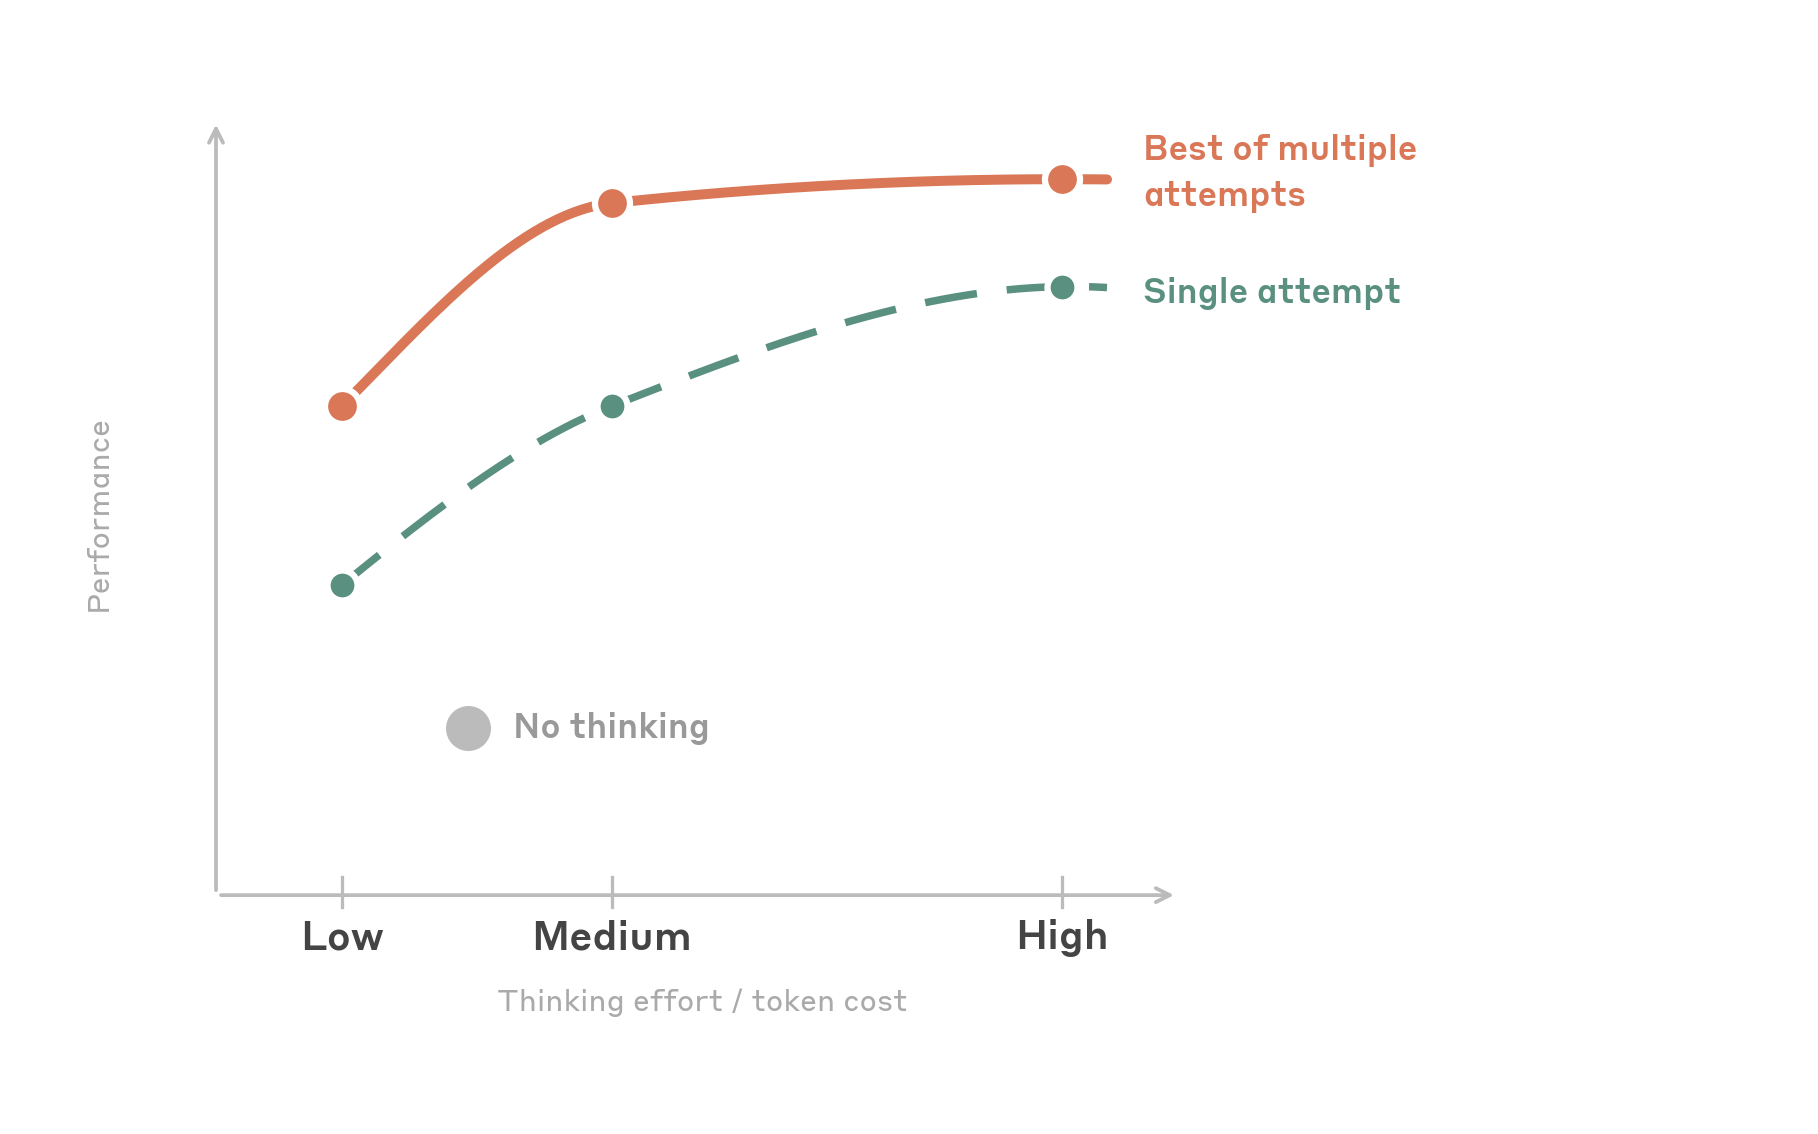
有两个模式很突出:
Medium effort 是性价比最高的选择。把 effort 设置为 medium,可以取得接近最高的任务成功率,同时输出 token 大约只有 high 的一半。超过 medium 后,性能提升会趋于平缓。值得注意的是,当任务允许重试时,medium 和 high 会收敛到相同的成功率。这意味着 high effort 可能帮助模型在第一次尝试时完成困难任务,但如果允许多次尝试,medium 往往能以更低成本同样可靠地完成。
少量思考就很有用。low effort 是一个出人意料地强的选项。它实际使用的总输出 token 比完全关闭 thinking 还少(因为模型犯错更少,需要的重试轮次更少),同时准确率持平或略高于不思考的情况。这使它成为对成本敏感、高吞吐工作负载的最佳选择。下面的表格概述了我们的 effort 建议。
我们不建议在 computer use 中使用 max effort。在我们的测试中,它相比 high 没有带来准确率收益,却进一步增加了输出 token 成本。UI 任务主要是感知型任务,而不是深度逻辑型任务,额外的推理预算要么用不上,要么会导致过度思考。请记住,随着模型演进,这条建议也会变化。
medium effort 级别的配置示例
import anthropic client = anthropic.Anthropic() response = client.beta.messages.create( model= "claude-sonnet-4-6" , max_tokens= 16000 , betas=[ "computer-use-2025-11-24" ], thinking={ "type" : "adaptive" }, output_config={ "effort" : "medium" }, messages=[...], tools=[ { "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : 1280 , "display_height_px" : 720 , } ], )
为什么更多思考不总是有帮助
UI 自动化任务和代码或数学问题有本质区别。大多数 computer use 动作都是感知型和机械型的:识别正确元素、点击正确位置,而不是进行深度逻辑推理。thinking 在以下情况下最有帮助:
• 开始前规划一个多步骤流程(例如:“我需要打开 Settings,进入 Privacy,然后关闭 tracking”)
• 从意外的 UI 状态中恢复(例如,出现了一个预料之外的对话框)
• 在屏幕上的信息和任务说明之间交叉核对
• 在专业软件中完成有挑战性的项目
提升安全性:利用 提示词 injection 分类器
本节介绍 提示词 injection 防护。如果你使用我们的官方 computer use 工具 header,这项防护默认提供且免费。不过,如果你有兴趣在自定义 computer 或 browser use 工具上启用它,请填写我们的 提示词 Injection Classifiers Interest Form。
computer use Agent 天生就会与不可信内容交互。Claude 处理的每一张截图、网页或应用 UI,都可能包含对抗性指令,包括隐藏文本、被操纵的图片、欺骗性 UI 元素,或者试图劫持 Agent 行为的社会工程攻击。这个攻击面与典型 API 集成有根本区别,典型 API 集成中输入由你控制;而在 computer use 中,模型的输入来自开放互联网,以及 Agent 正在操作的任何软件。
随着 computer use Agent 能力越来越强、部署越来越广,提示词 injection 也会成为更严重的风险。一个能够点击、输入和导航的 Agent,可能被操纵去执行现实世界中的操作,比如填写表单、下载文件或跳转到恶意 URL。为这些攻击建立稳健防御,是任何生产部署都必须做到的。
我们如何处理 提示词 injection 防御
我们已经详细介绍过针对 browser 和 computer use 的 提示词 injection 防御方法。我们的防御策略分为多层:
训练阶段鲁棒性。我们使用强化学习,把 提示词 injection 抵抗能力直接构建进 Claude 的能力中。在训练过程中,Claude 会接触嵌入模拟网页和应用 UI 中的注入内容,并在正确识别且拒绝遵循恶意指令时获得奖励。这意味着 Claude 的第一道防线就是模型本身,因为它已经学会区分合法的用户指令和任务执行过程中遇到的对抗性内容。
实时分类器。我们运行探针来扫描进入 Claude 上下文窗口的内容,并token潜在的 提示词 injection 尝试。这些探针会检测多种模态中的对抗性命令,例如隐藏在页面内容中的文本、嵌入图片中的指令,以及为了欺骗 Agent 而设计的误导性 UI 元素;一旦识别出攻击,就会相应调整 Claude 的行为。
持续红队测试。我们的安全研究人员会持续探测这些防御,并参与外部对抗性评估,用来基准测试面对不断演化攻击技术时的鲁棒性。
自最初的 computer use research p审查 以来,我们持续在这三层上投入大量资源。每一代新模型都会纳入更强的训练阶段防御和更有能力的分类器,我们也扩展了红队评估覆盖的攻击技术范围。
使用 Claude 内置分类器
当你通过 API 使用 Claude 官方 computer use 工具时,提示词 injection 分类器会在每个请求上自动运行。这些分类器与主模型推理并行工作,几乎不会增加额外延迟,也不会增加请求成本。
你不需要配置任何东西来启用这项保护。只要使用官方 computer_20251124 工具类型,它就默认开启。分类器会评估截图和其他内容中是否存在 提示词 injection 迹象,并相应影响 Claude 的响应。
# 使用官方 CU 工具时,分类器会自动运行 —— 不需要额外配置 tools = [ { "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : 1280 , "display_height_px" : 720 , } ]
如果你没有使用官方 computer use 工具
许多开发者会用自定义工具定义来构建 computer use 集成,而不是使用官方 computer_20251124 工具类型,例如定义自己的截图和点击工具。如果你的设置属于这种情况,上面描述的内置分类器目前不会在你的请求上运行。
我们正在积极探索如何把 提示词 injection 防护扩展到这些自定义实现。如果你正在构建未使用官方工具类型的 computer use 或 browser use 集成,并且对 提示词 injection 分类器感兴趣,请填写这个意向表。等这项能力可用时,我们会跟进联系你。
无论是否使用分类器,都应遵循的最佳实践
分类器只是其中一层防御,并不是完整解决方案。我们建议任何 computer use 部署都采用以下做法:
对高风险操作实现 human-in-the-loop。让 Agent 在执行不可逆操作前暂停并请求用户确认,例如提交表单、购买商品、发送消息或修改数据。无论分类器表现如何,这是缓解 提示词 injection 最有效的单一措施。
限制 Agent 的权限范围。限制 Agent 能做什么。如果你的工作流不需要下载文件,就不要给 Agent 下载文件的权限。如果它不需要发送邮件,就不要给它访问邮件客户端的权限。降低一次成功注入带来的影响范围,与阻止注入本身同样重要。
监控并记录 Agent 操作。记录 Agent 执行的完整动作序列,包括每一步的截图。这样你可以检测异常行为,在出问题时审计发生了什么,并建立反馈闭环,逐步提升系统鲁棒性。
把所有网页内容都视为不可信。设计 Agent 的 system 提示词 时,要清楚区分用户指令和任务执行过程中遇到的内容。提醒模型:网页、邮件或应用 UI 中发现的文本并非来自用户,不应被当作指令。
computer use 的上下文管理
构建 computer use Agent 时,截图会快速累积。每个动作都会生成一张新图片,每张图片根据分辨率不同大约消耗 1,000 到 1,800 个 token。再加上 system 提示词、工具定义和文本内容后,一个 200k 上下文窗口可能不到 100 张截图就会被填满。
良好的上下文管理有两个目标:1)控制总 token 数量;2)保持 提示词 caching 有效,避免你为相同前缀反复支付全价。我们发现,对长时间运行的 Agent 来说,有效的上下文管理对成本和延迟的影响,几乎超过任何其他优化。本节介绍三层可以清晰组合的做法:放置 cache breakpoint、在不破坏缓存的情况下裁剪旧截图,以及当裁剪仍不够时总结历史。
放置 cache breakpoint
只有当断点落在后续多轮对话中会重复出现的内容上时,提示词 caching 才有帮助。API 总共支持四个缓存断点。把四个断点全放在稳定前缀上(system 提示词、工具定义)会浪费,因为这个前缀已经命中过一次,而且不会失效,所以一个断点就够了。其他三个断点更适合放在最近的历史内容上,因为那里失效风险最高,而且在长会话中节省效果会不断累积。
我们建议:
• 在 system 提示词 或末尾的工具定义上放一个断点。这个前缀在一个会话内很少变化。
• 最多再把三个额外断点放在最近的 tool results 上,每轮向前推进,并清掉上一轮的断点,避免超过四个断点的限制。
把断点分散到最近的几个位置,可以带来更平滑的降级效果。如果最新的断点失效了,比如因为图片被裁剪、发生 compaction,或工具定义变化,前一个断点仍然可能命中,这样你支付的是完整输入成本的 10%,而不是 100%。
cache control 和设置断点的示例:
def set_trailing_cache_control ( messages, max_breakpoints= 3 ): """在清除所有已有token后,把最多 `max_breakpoints` 个 ephemeral cache_control token放到最近的 tool_result 块上。""" for msg in messages: for block in msg.get( "content" , []): if isinstance (block, dict ): block.pop( "cache_control" , None ) placed = 0 for msg in reversed (messages): for block in reversed (msg.get( "content" , [])): if placed >= max_breakpoints: return if isinstance (block, dict ) and block.get( "type" ) == "tool_result" : block[ "cache_control" ] = { "type" : "ephemeral" } placed += 1
方案 1:滚动缓冲区(缓存感知)
控制 token 数量最简单的方法,是只保留最近 N 张截图,丢掉其他截图。每次 API 调用前,遍历 message 数组,把较旧的 image block 替换成一个简短占位符(例如一个写着“[Image omitted]”的 text block)。
这个模式的朴素版本是截图过期时一张一张丢弃,这会让前缀每轮都变化,并持续让 提示词 cache 失效。这也是滚动缓冲区被认为会破坏缓存的原因。修复方式是批量裁剪,这样前缀可以在连续多轮中保持字节级完全一致,然后只失效一次,之后再保持稳定。
我们测试过的一个具体模式是:
• 以完整分辨率保留最近的 keep_n 张截图。
• 一旦截图总数超过 keep_n + interval,就一次性把最旧的 interval 张截图替换成占位符。
• 在两次裁剪事件之间,message 数组在多轮中是字节级完全一致的,所以缓存断点会持续命中。
建议从这些默认值开始:keep_n = 3,interval = 25。这些值可以调整。更高的 interval 意味着更少的裁剪事件(缓存效率更好),但也意味着上下文里会保留更长一段完整分辨率截图尾部(更多 token)。请在有代表性的执行轨迹上测量缓存命中率和总输入 token 数,然后再调整。
在保留缓存断点的同时裁剪旧截图的示例:
def prune_old_screenshots ( messages, keep_n= 3 , interval= 25 ): """批量把旧截图替换成文本占位符。只有当总数超过 keep_n + interval 时才裁剪,所以两次裁剪之间,message 前缀会在 `interval` 轮内保持字节级稳定。""" image_positions = [ (msg_idx, block_idx) for msg_idx, msg in enumerate (messages) for block_idx, block in enumerate (msg.get( "content" , [])) if isinstance (block, dict ) and block.get( "type" ) == "image" ] if len (image_positions) <= keep_n + interval: return messages to_prune = image_positions[:-keep_n][-interval:] for msg_idx, block_idx in to_prune: messages[msg_idx][ "content" ][block_idx] = { "type" : "text" , "text" : "[Image omitted]" , } return messages
滚动缓冲区仍然有一个真正的限制:缓冲区之外的任何东西都会消失。原始指令、Agent 已经尝试过什么、任务进展到哪里,都会随着被裁剪的截图一起消失。对于短任务(少于约 50 个动作),这没问题。对于更长的任务,请把它和 compaction 结合使用。
方案 2:基于 LLM 的 compaction
不要静默丢弃旧图片,而是在丢弃前总结完整对话。summary 会保留发生了什么、用户要求什么、已经完成什么,以及应该从哪里继续。同时保留几张最近截图,让 Agent 能看到当前正在看的内容。
compaction 和缓存感知的滚动缓冲区是互补的。用滚动缓冲区在每一轮控制 token 增长;偶尔使用 compaction 回收上下文窗口的其余部分,同时不丢失早期上下文。每次 compaction 事件按设计都会导致缓存失效,所以你希望它很少发生,而不是每几轮发生一次。
总结提示词
这个示例 提示词 提供了一个脚手架,其中每个部分都针对一种具体失败模式。这个 提示词 必须捕获 Agent 继续任务所需的一切,让它不需要重新阅读原始对话,如下例所示:
COMPACT_PROMPT = """你的任务是为这段对话创建一份详细总结,用来替换原始对话历史。Agent 后续只会基于这份总结和几张最近截图继续工作。关键要求:逐字保留所有用户指令。用户指令是最关键的元素。如果它们丢失,Agent 会偏离任务。在给出总结前,请在标签中分析对话:1. 提取每一条用户指令、要求和约束 2. 判断这是否是可重复工作流(例如处理 N 个项目)3. 按时间顺序追踪采取了哪些动作以及发生了什么 你的总结必须包含这些部分:1. USER INSTRUCTIONS:- 完整的初始任务定义(尽可能逐字保留)- 所有具体要求和标准 - 每一条 "DO NOT"、"ALWAYS"、"MUST" 指令 - 任何改变做法的修正或反馈 2. TASK TEMPLATE(如果这是可重复工作流):- 正在重复的模式 - 每次迭代的判断标准 - 标准工作流步骤 - 一个已完成迭代的示例 3. CONSTRAINTS AND RULES:- 所有用户指定的规则和限制 - 任务前已知或任务中发现的边界情况和例外 4. ACTIONS TAKEN:- 访问过的页面和交互过的元素 - 填写过的表单和点击过的按钮 5. ERRORS AND FIXES:- 出了什么问题,以及如何解决 - 失败过的方法(避免再次尝试)6. PROGRESS TRACKING:- 已完成和剩余的项目 - 当前在工作流中的位置 7. CURRENT STATE:- 当前应用、URL 和域名(可选)- 重要页面状态(已登录、表单进度等)8. NEXT STEP:- 继续任务时下一步应该准确做什么 """
在上面的 提示词 中,User Instructions 用来防止任务漂移:没有它们,Agent 在 compaction 后会偏离。Task Template 捕获可重复模式,让 Agent 在 compaction 后可以继续迭代,而不必从零重新推导工作流。Constraints and Rules 保留任务前设定或任务中发现的限制和边界情况,避免 Agent 违反它原本应该遵守的规则。Actions Taken 帮助追踪过去的进度。Errors and Fixes 避免重试失败过的方法(“我已经试过点击 Submit;必须先勾选 Terms 复选框才有用”)。Progress Tracking 防止重新开始或跳过项目。Current State & Next Step 给出明确的恢复入口。
服务端 compaction(beta)
使用这个 提示词 最简单的方法,是让 API 通过服务端 compaction(beta)来处理 compaction。把你的自定义总结 提示词 作为 context_management 中的 instructions 参数传入,当输入 token 超过触发阈值时,API 会自动总结。instructions 参数会完全替换默认总结 提示词,所以模型会遵循上面的那些部分。设置 pause_after_compaction,可以在 compaction 事件之间附带最近的消息(包括截图)。
使用 autocompaction 工具的示例:
# 最小配置:用 API 默认值开启 autocompaction response = client.beta.messages.create( model= "claude-opus-4-7" , max_tokens= 16000 , betas=[ "compact-2026-01-12" , "computer-use-2025-11-24" ], context_management={ "edits" : [{ "type" : "compact_20260112" }]}, messages=[...], tools=[...], ) # 自定义配置:设置你自己的触发阈值和总结 提示词 response = client.beta.messages.create( model= "claude-opus-4-7" , max_tokens= 16000 , betas=[ "compact-2026-01-12" , "computer-use-2025-11-24" ], context_management={ "edits" : [ { "type" : "compact_20260112" , "trigger" : { "type" : "input_tokens" , "value" : 150_000 }, "instructions" : COMPACT_PROMPT, } ] }, messages=[...], tools=[...], )
在客户端截断以匹配服务端
当 API 执行服务端 compaction 时,它会在服务端替换 compaction 之前的内容,但你的本地 messages 数组仍然保存着完整历史。如果你后续每轮仍然发送完整历史,你会为服务端已经不再需要的 token 付费,而且你的滚动缓冲区裁剪器会作用在一个和服务端实际看到的内容不同的 message 片段上,这可能破坏你前面精心维护的缓存稳定前缀。
修复方式是在客户端镜像服务端的截断,如下面代码片段所示。当 response 报告发生了 compaction 时,在下一轮之前,从本地 messages 数组中删除 compaction token之前的所有内容。这样可以让客户端和服务端视图保持一致,并让滚动缓冲区继续正确工作。
def truncate_to_last_compaction ( messages, response ): """如果服务端在这一轮执行了 compaction,就在本地丢弃 compaction 前的消息,这样下一轮的缓存前缀会和服务端看到的内容一致。""" context_mgmt = getattr (response, "context_management" , None ) if not context_mgmt or not context_mgmt.get( "applied_edits" ): return messages compaction = next ( (e for e in context_mgmt[ "applied_edits" ] if e[ "type" ] == "compact" ), None , ) if compaction is None : return messages keep_from = compaction[ "message_index_after_compaction" ] return messages[keep_from:]
客户端 compaction
如果你使用的模型不支持服务端 compaction,或者你想完全控制,可以用同一个 提示词 在客户端实现 compaction。每次 API 调用后,从 response usage 字段检查总输入 token 数。当它超过某个阈值(例如上下文窗口的 90%)时,把对话发送给一个 summarizer model,并把 COMPACT_PROMPT 作为 system 提示词。然后用 summary 加几张最近截图替换 message history,再继续 Agent loop。
组合起来
一个适合长时间运行的 computer use Agent 的良好默认配置如下:
• 在稳定前缀上放一个缓存断点,在末尾 tool results 上放三个断点,并在每轮清除后重新放置。
• 使用缓存感知的滚动缓冲区,keep_n = 3,interval = 25,批量把旧截图替换为占位符。
• 在大约 150k 输入 token 时触发服务端 compaction,使用自定义 提示词,并加上一道客户端截断步骤,让两边视图保持一致。
有了这三层机制,一个典型的长周期 CU 会话会在绝大多数轮次命中 提示词 cache,把总输入 token 控制在远低于上下文窗口的位置,并通过 compaction 事件保留足够历史,让 Agent 不会忘记任务进展。
用于改进 computer 和 browser use 的实验性设置
下面这些模式是我们在实现中测试过、看起来有潜力的技术,但还不是通用建议。每种方法都会用复杂度或成本换取特定工作负载上的潜在提升。我们把它们放在这里,方便你在自己的工作流中尝试,但请预期本节指导会快速变化。
批量工具
在更新后的参考实现中,我们在标准 computer 和 browser 工具旁边暴露了两个工具:computer_batch 和 browser_batch。每个工具都接受一组子动作,并在一次工具调用中执行。例如,模型可以发出一次 computer_batch 调用,其中包含 click、type 和 press key 三个动作,而不是分成三轮。
吸引人的地方在于效率:包含 N 个机械动作的工作流可以用一次往返完成,而不是 N 次往返。对于长周期任务,这能显著减少实际耗时和输出 token 消耗。风险在于错误会叠加:如果动作 2 依赖动作 1 改变后的视觉状态,而动作 1 没有成功,后面的批量动作就会基于过期假设继续执行,Agent 可能在没有看到真实状态截图的情况下逐渐偏离。
当子动作彼此独立、不依赖彼此的视觉结果时,我们建议使用批量工具(例如填写表单中的多个字段、串联键盘快捷键、滚动并点击已知目标)。在探索式导航、错误恢复序列,或任何“如果动作 1 失败我就需要重新规划”的真实场景中,我们会避免使用它们。
因为批量工具是你自己的自定义定义,所以它们可以和标准 computer 或 browser 工具很好地叠加。两类工具都保留,让模型自行选择。
advisor tool(beta)
advisor tool 会把一个执行器模型和一个更高智能的 advisor 模型配对,执行器可以在生成过程中向 advisor 咨询战略指导。执行器负责运行循环,当遇到需要更深推理的问题时,就调用 advisor,收到计划或路线修正后继续执行。这一切都在服务端的单个请求内部完成,你这边不需要额外往返请求。
具体到 computer use,这种模式最适合长周期任务:大多数轮次只是机械点击,但偶尔的规划时刻,比如选择打开哪个标签页、从意外弹窗中恢复、决定是否放弃某个策略,会受益于 Opus 级别的推理能力。你可以获得接近 advisor 单独执行的质量,同时大部分 token 生成仍按执行器的速率完成。
启用 advisor tool 的示例:
response = client.beta.messages.create( model= "claude-sonnet-4-6" , max_tokens= 16000 , betas=[ "advisor-tool-2026-03-01" , "computer-use-2025-11-24" ], tools=[ { "type" : "advisor_20260301" , "name" : "advisor" , "model" : "claude-opus-4-7" , }, { "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : 1280 , "display_height_px" : 720 , }, ], messages=[...], )
advisor tool 的常用控制项包括:
• max_uses:限制每个请求中的 advisor 调用次数。当你想控制最坏情况下的成本时很有用。
• 在你的运行框架中设置全会话上限:advisor 每次咨询都按 Opus 4.7 的费率计费,所以在很长的会话中,你可能希望在使用达到一定次数后停止提供 advisor。
• advisor 侧缓存:在多次调用的对话中,大约三次咨询后,缓存 advisor 的前缀就开始划算。在参考实现中,我们默认使用 5 分钟的临时缓存。
有两点不太直观但值得知道:advisor 运行时没有工具,也没有上下文管理,所以它不能替你点击或浏览,只能返回文本建议。另外,因为执行器模型在长周期任务中不一定总记得 advisor 存在,请参考下面的提醒提示部分。
清理孤立的 advisor 块
advisor tool 触发时,执行器会在返回内容中输出一个 name: "advisor" 的 server_tool_use 块,后面跟着一个 advisor_tool_result 块。这些块会和其他内容一起存在你的 messages 数组里。
如果你之后从 tools 数组中移除了 advisor tool,比如因为达到了全会话上限、修改了配置,或切换了模型,那么之前的 server_tool_use / advisor_tool_result 块就会变成孤立块。下一次请求时,API 会返回 400,因为它们引用的工具已经不再声明。
修复方法是做一次简单的发送前处理:每当某一轮禁用 advisor 时,遍历消息历史,移除所有 type 为 server_tool_use 且 name == "advisor" 的内容块,以及 advisor_tool_result 内容块。
移除过期 advisor 块的示例:
def strip_orphaned_advisor_blocks ( messages ): """从历史中移除 advisor server_tool_use / tool_result 块。请在任何不包含 advisor tool 的请求之前调用它。""" for msg in messages: content = msg.get( "content" ) if not isinstance (content, list ): continue msg[ "content" ] = [ block for block in content if not ( isinstance (block, dict ) and ( (block.get( "type" ) == "server_tool_use" and block.get( "name" ) == "advisor" ) or block.get( "type" ) == "advisor_tool_result" ) ) ] return messages
周期性提醒提示
在长会话中,执行器模型可能会忘记有哪些工具可用,或者忘记应该优先使用哪些工具。我们在测试中发现两种短提醒模式很有帮助:
批处理提醒。如果你在标准工具旁边暴露了 computer_batch 或 browser_batch,并且观察到模型在本该使用批处理时仍然连续调用单个动作,可以在下一次工具结果后追加一条简短的系统级提示:"Remember you can use computer_batch to combine sequential actions in a single tool call when they don't depend on intermediate screenshots." 目标是把模型拉回到批处理思路上,但不强行规定具体何时使用。
advisor 提醒。执行器很容易忘记 advisor tool 的存在,尤其是很多轮都没有调用过它时。对于超过约 20 轮且没有 advisor 调用的会话,可以追加一条简短提醒,说明 advisor 可用于规划或路线修正时刻。在参考实现中,我们使用 20 轮的节奏,并追加一行提示。
这两种提醒都是轻量级的上下文注入,不是重写 system 提示词。每次追加只会消耗几十个输入 token。如果你的 system 提示词 已经很长,或者你的缓存断点放得很精确,就需要权衡这点提升是否值得承担额外的缓存失效风险。
参考实现中的调试模式
当某些行为异常,而你不确定问题出在运行框架、截图,还是模型本身时,在开始添加日志前,参考实现中的三个辅助工具值得先用起来:
• Trajectory viewer(streamlit run viewer/app.py)。加载已记录的轨迹,让你逐步查看 Agent 的每一轮,包括截图、思考过程、工具调用和每步用量。它最适合在失败运行后回答这个问题:“模型实际看到了什么,又做了什么决定?”
• Tool debug panel(uvicorn debug.server:app --reload)。一个小型 Web UI,可以让你单独测试每个工具:截图、捕获点击坐标、输入、滚动、缩放。它适合确认你的截图管线和坐标缩放是否真的产生了预期结果。
• Localization playground(uvicorn localize.server:app --reload --port 8001)。上传任意图片,让模型指出目标位置。它会把预测坐标按显示分辨率和原始分辨率都渲染回你的图片上。这是诊断点击偏差最快的方法,可以判断问题是 resize bug、坐标缩放 bug,还是模型真实错误。当客户报告点击不准,而你想单独复现失败时,这尤其有用。
这些工具都不是构建可用集成的必要条件;它们只是调试辅助,用于默认反馈循环,也就是记录日志、重新运行、费劲查看 transcript,不够快的时候。
提升可靠性:教 Claude
与其反复调整文本 提示词,直到 Claude 做对某个工作流,不如直接向它展示正确行为。你可以录制自己执行任务的过程,在每一步捕获截图、动作,并可选地加入语音讲解,然后在 Claude 执行同一工作流时,把这段演示作为上下文回放给它。这个录制会变成一份可复用的规范,Claude 可以跟随它执行,并适应实时 UI 状态中的差异。
我们在 Claude in Chrome 内部使用这种模式,并称之为 "Teach Mode"。我们在这里分享它,是因为底层方法对任何构建 computer use 或 browser use 产品的人都很有用。它有两方面帮助:一是提高那些 Claude 大体能处理但偶尔会出错的工作流的可靠性;二是解锁仅靠文本 提示词 无法让 Claude 完成的全新工作流。核心思路,也就是捕获演示并把它作为上下文喂回去,实现起来很直接,并且能很好适配浏览器和桌面环境。
核心概念:展示,而不是描述
传统 提示词 engineering 要求用户用文字描述需求,然后在 AI 误解时继续迭代。这个模式反过来:用户演示任务,系统记录他们的动作、截图,以及可选的语音讲解。回放时,Claude 会收到完整演示作为上下文,并跟随相同步骤执行,同时适应当前 UI 状态中的任何差异。
关键洞察是:回放不是严格重放。Claude 会把演示当作指导,同时对实时环境进行推理。如果按钮移动了,或者菜单被重新组织了,Claude 可以在当前 UI 中找到等价元素,而不是盲目点击已记录的坐标。
数据模型
基本单位是一个“workflow step”,也就是录制过程中捕获的单个动作。每个 step 会打包做了什么、发生在哪里,以及当时屏幕是什么样:
from dataclasses import dataclass, field from typing import Literal , Optional @dataclass class WorkflowStep : action: Literal [ "click" , "type" , "navigate" , "scroll" , "select" ] description: str # 人类可读,例如 "Click the Submit button" timestamp: float selector: Optional [ str ] = None # CSS selector 或 XPath coordinates: Optional [ dict ] = None # {"x": int, "y": int} url: Optional [ str ] = None screenshot: Optional [ str ] = None # Base64 编码的截图 viewport_dimensions: Optional [ dict ] = None # {"width": int, "height": int} speech_transcript: Optional [ str ] = None # 如果捕获了语音讲解,就放这里 value: Optional [ str ] = None # 用于 type 动作 @dataclass class SavedWorkflow : id : str name: str # 例如 "Submit expense report" steps: list [WorkflowStep] = field(default_factory= list ) description: Optional [ str ] = None # AI 生成的工作流摘要 start_url: Optional [ str ] = None created_at: float = 0.0 usage_count: int = 0
同时捕获 selector 和坐标是有意设计的:selector 对布局变化更稳健,但当 selector 失效时,坐标可以提供一个 Claude 能使用的视觉兜底。保存 viewport dimensions 是为了在回放环境和录制环境不同时,可以对坐标进行缩放。
录制:需要捕获什么
至少要捕获点击事件、键盘输入、导航变化,以及每个动作时的一张截图。对于每次点击,要生成一段人类可读的描述,可以来自 aria-label、文本内容,或通过一次快速 Claude 调用生成,并在截图上用视觉token标注点击位置:
def on_click ( event ): step = WorkflowStep( action= "click" , selector=generate_selector(event.target), coordinates={ "x" : event.client_x, "y" : event.client_y}, url=current_url(), description=generate_description(event.target), timestamp=now(), viewport_dimensions=get_viewport_size(), ) # 在点击位置用圆圈标注截图 screenshot = capture_screenshot() step.screenshot = annotate_with_circle(screenshot, event.client_x, event.client_y) workflow_steps.append(step)
这个标注,也就是点击位置上的彩色圆圈,有两个作用:帮助用户确认录制确实捕获了正确元素;在回放时明确告诉 Claude 动作发生在哪里。你的回放 提示词 应该说明这些token是录制产生的辅助标注,不是实时 UI 的一部分。
回放:构造 提示词
这是最重要的部分。当用户触发一个已保存的工作流时,你要构造一条发给 Claude 的消息,其中包含三件事:用户意图、解释演示格式的上下文块,以及录制的截图。
上下文块会告诉 Claude 如何理解带标注的截图,以及当实时 UI 不同时该如何适应:
def generate_playback_context ( steps: list [WorkflowStep] ) -> str : steps_description = "\n" .join( f"Step {i+ 1 } : {step.description} " for i, step in enumerate (steps) ) return f"""<demonstration_context> 用户录制了一段演示,展示如何完成这个任务。已录制步骤:{steps_description} 关于截图:- 每张截图都展示了某个动作发生时的屏幕状态 - 蓝色圆圈token用户点击的位置,这些是录制标注 - 蓝色高亮不是实际界面的一部分 - 你自己的截图中不会有这些token 如何使用这个演示:1. 查看所有步骤和截图,理解完整工作流 2. 截取你自己的截图,查看当前页面状态 3. 蓝色高亮显示要交互的元素,请在当前视图中找到它 4. 按相同动作顺序执行,并适应任何差异 5. 如果 UI 发生了明显变化,请自行判断并寻找等价元素 </demonstration_context>"""
然后把用户 提示词、上下文块,以及每个 step 的截图作为 image 组装成完整消息:
import anthropic client = anthropic.Anthropic() content = [ { "type" : "text" , "text" : user_提示词}, { "type" : "text" , "text" : generate_playback_context(workflow.steps)}, ] for i, step in enumerate (workflow.steps): if step.screenshot: content.append({ "type" : "text" , "text" : f"[Step {i+ 1 } : {step.description} ]" }) content.append({ "type" : "image" , "source" : { "type" : "base64" , "media_type" : "image/jpeg" , "data" : step.screenshot}, }) response = client.beta.messages.create( model= "claude-sonnet-4-6" , max_tokens= 4096 , betas=[ "computer-use-2025-11-24" ], messages=[{ "role" : "user" , "content" : content}], tools=[{ "type" : "computer_20251124" , "name" : "computer" , "display_width_px" : 1280 , "display_height_px" : 720 , }], )
回放模式
不是每个工作流都需要同样严格地遵循录制演示。有些工作流太长,会消耗大量输入 token,最终降低延迟表现并增加成本。可以考虑支持一个 strictness 参数,并把它放进上下文 提示词:
Strict:严格按步骤执行;如果 UI 变化太大,就停止并报告。适合对合规敏感、精确步骤顺序很重要的工作流。
Adaptive:把演示作为指导,但适应 UI 变化。这是大多数用例的最佳默认值,它能优雅处理轻微布局移动、更新后的按钮文案,以及重新组织过的菜单。
目标导向:关注最终结果;把录制下来的步骤当作提示,而不是严格指令。当 UI 经常变化但目标保持不变时,这种方式很有用。可以用一个模型总结录制的演示,采用类似下一节所述的策略,然后把这份总结传给 CU model。
示例:端到端费用报销工作流
下面展示一个保存后的工作流在实际中是什么样子。这个工作流记录了五个步骤:进入费用表单、选择费用类型、从下拉菜单中选择“Travel”、输入金额,然后点击 Submit。
expense_workflow = SavedWorkflow( id = "wf_abc123" , name= "Submit Expense Report" , start_url= "https://expenses.company.com/new" , steps=[ WorkflowStep( action= "navigate" , url= "https://expenses.company.com/new" , description= "进入新的费用表单" , timestamp= 1700000000 , ), WorkflowStep( action= "click" , selector= "#expense-type-dropdown" , coordinates={ "x" : 400 , "y" : 200 }, description= "点击费用类型下拉菜单" , timestamp= 1700000001 , ), WorkflowStep( action= "click" , selector= "[data-value='travel']" , coordinates={ "x" : 400 , "y" : 280 }, description= '选择“Travel”费用类型' , timestamp= 1700000002 , ), WorkflowStep( action= "type" , selector= "#amount-input" , value= "150.00" , description= "输入费用金额" , timestamp= 1700000003 , ), WorkflowStep( action= "click" , selector= "#submit-expense-btn" , coordinates={ "x" : 1150 , "y" : 420 }, description= "点击 Submit 按钮" , speech_transcript= "现在我会点击 submit,把这份报告发送去审批" , timestamp= 1700000004 , ), ], )
当用户之后说“帮我提交团队午餐的费用报销($85.50)”时,回放服务会构造一个 提示词,其中包含演示上下文、全部五张带标注的截图,以及新请求中的具体值。Claude 能准确看到应该点击哪里、按什么顺序操作,并会调整金额和描述来匹配当前任务。如果你的工作流太长,导致输入 token 数过多而不适合直接采用这种方式,可以先压缩工作流,再把它作为示例使用。关于管理上下文的技巧,请参见下一节。
开始使用计算机和浏览器操作
这些实践反映了我们目前对如何让计算机操作集成在生产环境中保持可靠的最佳理解。它们适用于 Claude 4.6 模型系列和 Opus 4.7,并会随着新模型和新技术的出现而更新。
随着你的集成逐渐成熟,最重要的模式会取决于你的具体环境、目标应用,以及可靠性要求。
可以从计算机操作文档开始,查看我们新的最佳实践 demo 实现,或者回顾最初的计算机操作研究文章,了解这些能力是如何构建出来的,以及未来会走向哪里。
致谢:本文和对应的 demo 由 Lucas Gonzalez 与 Luca Weihs 撰写。作者感谢 Molly Vorwerck、Javier Rando、Maya Nielan、Gabe Mulley 和 Brigit Brown 的贡献。