改进 skill-creator:测试、衡量并打磨 Agent Skills
Skill 作者现在可以验证自己的 Skills 是否有效,及时发现回归,并改进 description。
skill-creator 现在可以帮助你编写 evals、运行 benchmark,并在模型持续演进时保持 Skills 可用。这些更新已经在 Claude.ai、Cowork、Claude Code 插件以及我们的 repo 中可用。
自去年 10 月发布 Agent Skills 以来,我们发现大多数作者是领域专家,而不是工程师。他们熟悉自己的工作流,却缺少工具来判断:某个 Skill 在新模型上是否仍然有效、是否会在正确时机触发、修改后是否真的变好了。
今天我们发布 skill-creator 的增强功能,帮助作者更有信心地构建 Skills。我们把软件开发中的一些严谨方法,如测试、benchmark 和迭代改进,带到 Skill 编写中,同时不要求作者写代码。
两类 Skills
Skills 通常分为两类:
能力增强型 Skills 帮助 Claude 完成基础模型做不到,或无法稳定做到的事情。文档创建类 Skills 就是很好的例子:它们编码了比单纯 prompting 更能产出好结果的技巧和模式。
偏好编码型 Skills 记录的是工作流。Claude 本来已经能完成其中每个步骤,但 Skill 会按照你团队的流程把这些步骤串起来。例如:按固定标准审查 NDA 的 Skill,或从多个 MCP 获取数据并起草周报的 Skill。
区分这两类很重要,因为它们需要测试的原因不同:
• 随着模型变强,能力增强型 Skills 可能会变得没那么必要。evals 可以告诉你什么时候发生了这种变化。
• 偏好编码型 Skills 更持久,但价值取决于它们是否忠实反映你的真实工作流。evals 用来验证这种一致性。
无论哪种情况,测试都会把“看起来可用”的 Skill 变成“你知道它可用”的 Skill。
用 evals 测试和改进 Skills
skill-creator 现在会帮助你编写 evals。evals 是一种测试,用来检查 Claude 对给定 prompt 是否按预期行动。如果你写过软件测试,这会很熟悉:定义测试 prompt(必要时附带文件),描述好结果长什么样,然后让 skill-creator 判断 Skill 是否经得住测试。
例如,我们的 PDF Skill 以前很难处理不可填写的表单。Claude 需要在没有字段指引的情况下,把文字放到精确坐标上。evals 隔离出了这个失败点,我们随后发布了一个修复,把定位锚定到提取出的文本坐标上。
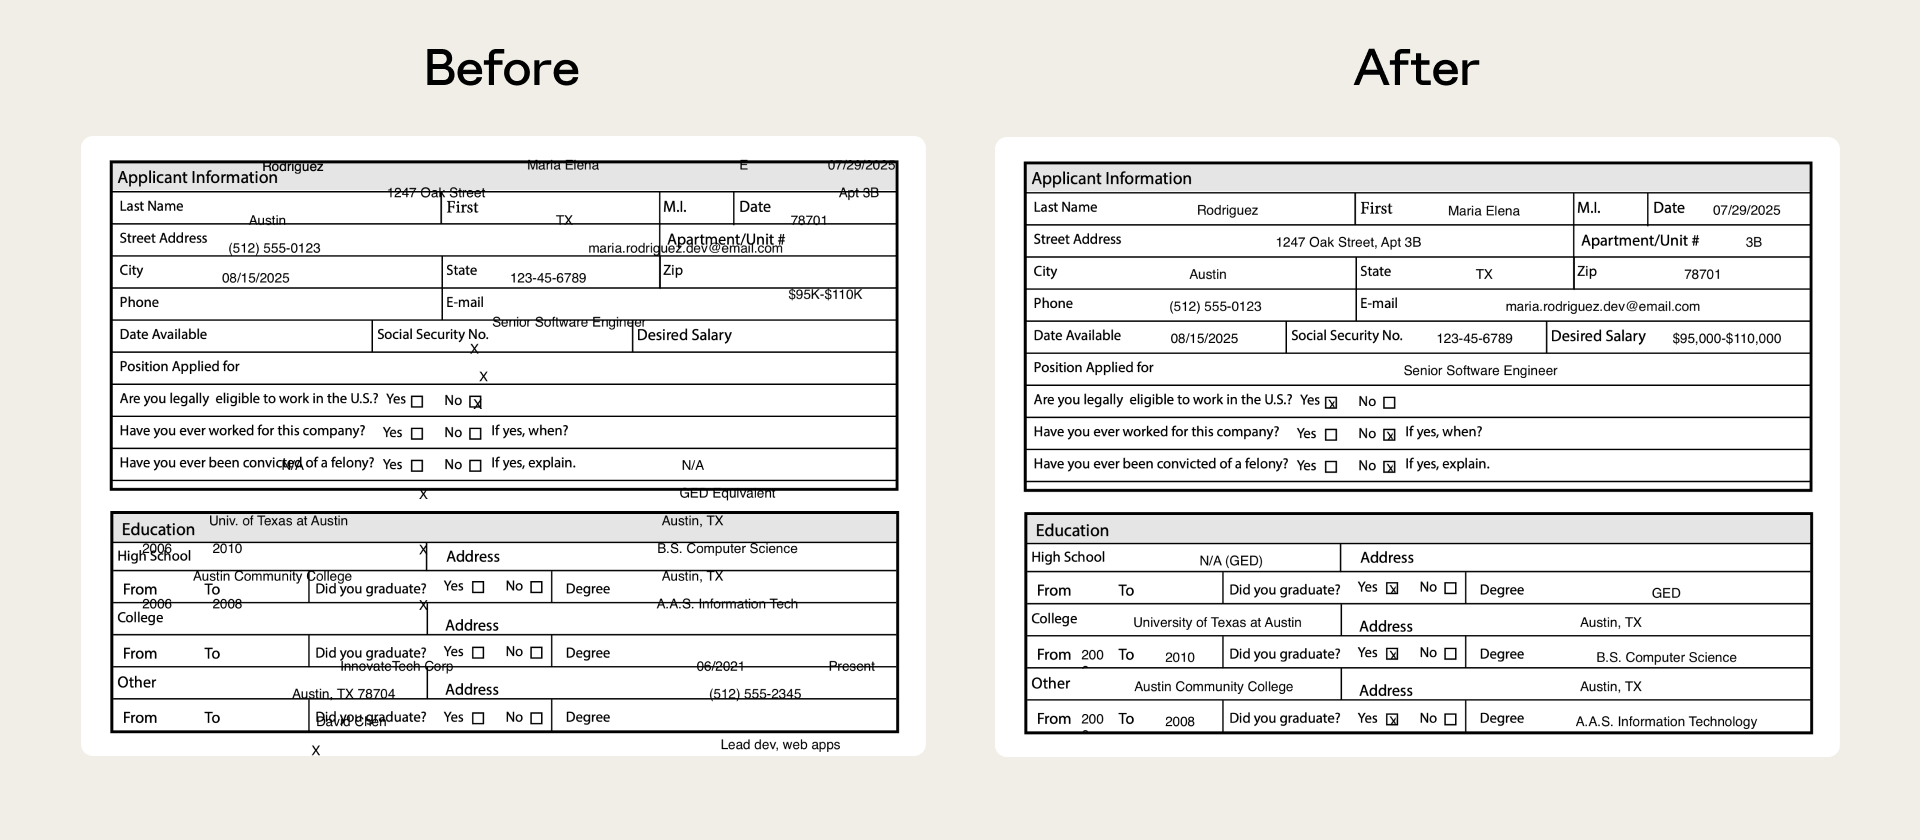
evals 有很多用途,其中两个重要用途是发现质量回归,以及理解模型能力进步。
第一,发现质量回归。随着模型和周边基础设施演进,上个月表现良好的 Skill 今天可能会出现不同行为。用新模型运行 evals,可以在问题影响团队工作前给你早期信号。
第二,知道基础模型能力什么时候已经超过你的 Skill。这主要适用于能力增强型 Skills。如果不加载 Skill 时,基础模型也能通过你的 evals,就说明 Skill 中的技巧可能已经进入模型默认行为。Skill 没坏,只是可能不再必要。
我们还加入了 benchmark 模式,可以用你的 evals 运行标准化评估。你可以在模型更新后运行它,也可以在迭代 Skill 时运行。它会跟踪 eval 通过率、耗时和 token 使用量。
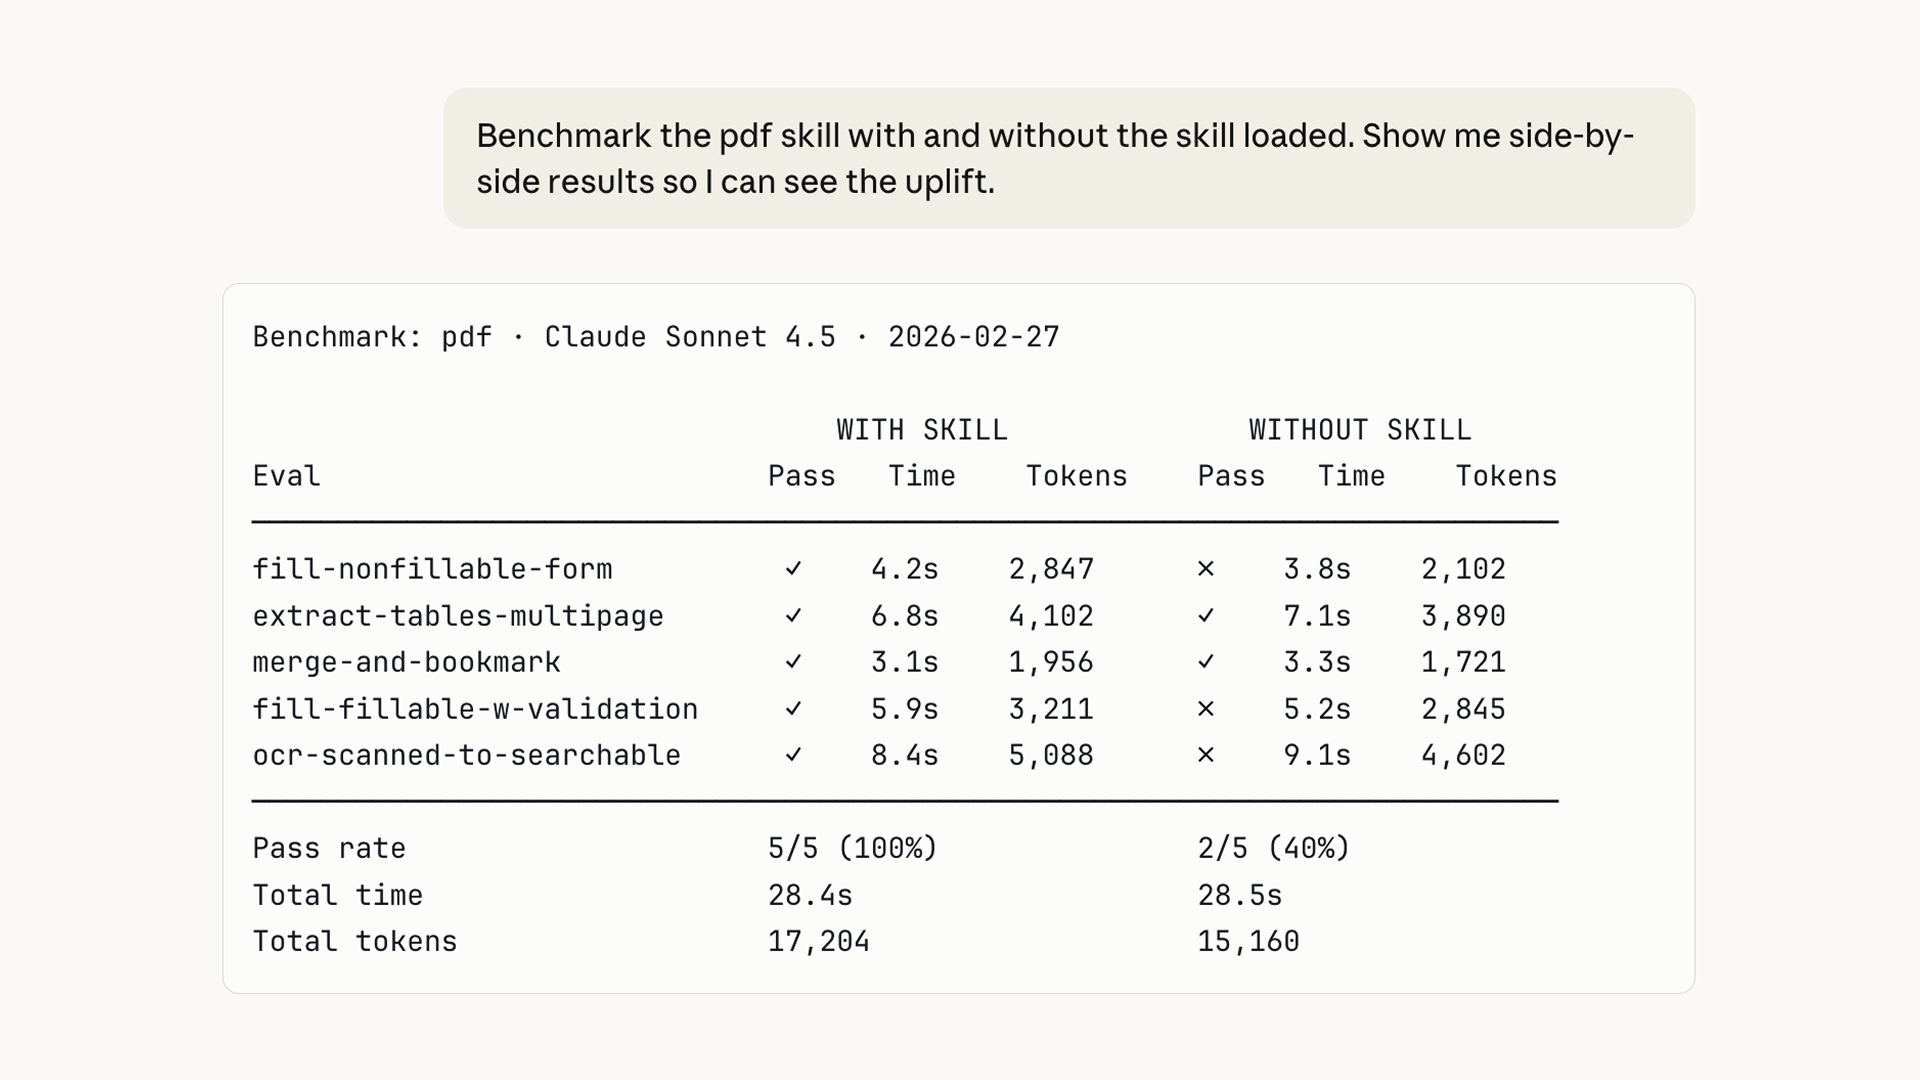
你的 evals 和结果由你自己保存。你可以放在本地、接入 dashboard,或集成到 CI 系统。
用多 Agent 支持实现更快、更一致的评估
顺序运行 evals 可能很慢,而且累积上下文会在测试之间互相影响。skill-creator 现在支持启动独立 Agent 并行运行 evals,每个 Agent 都有干净上下文,并记录自己的 token 和耗时指标。结果更快,也不会交叉污染。
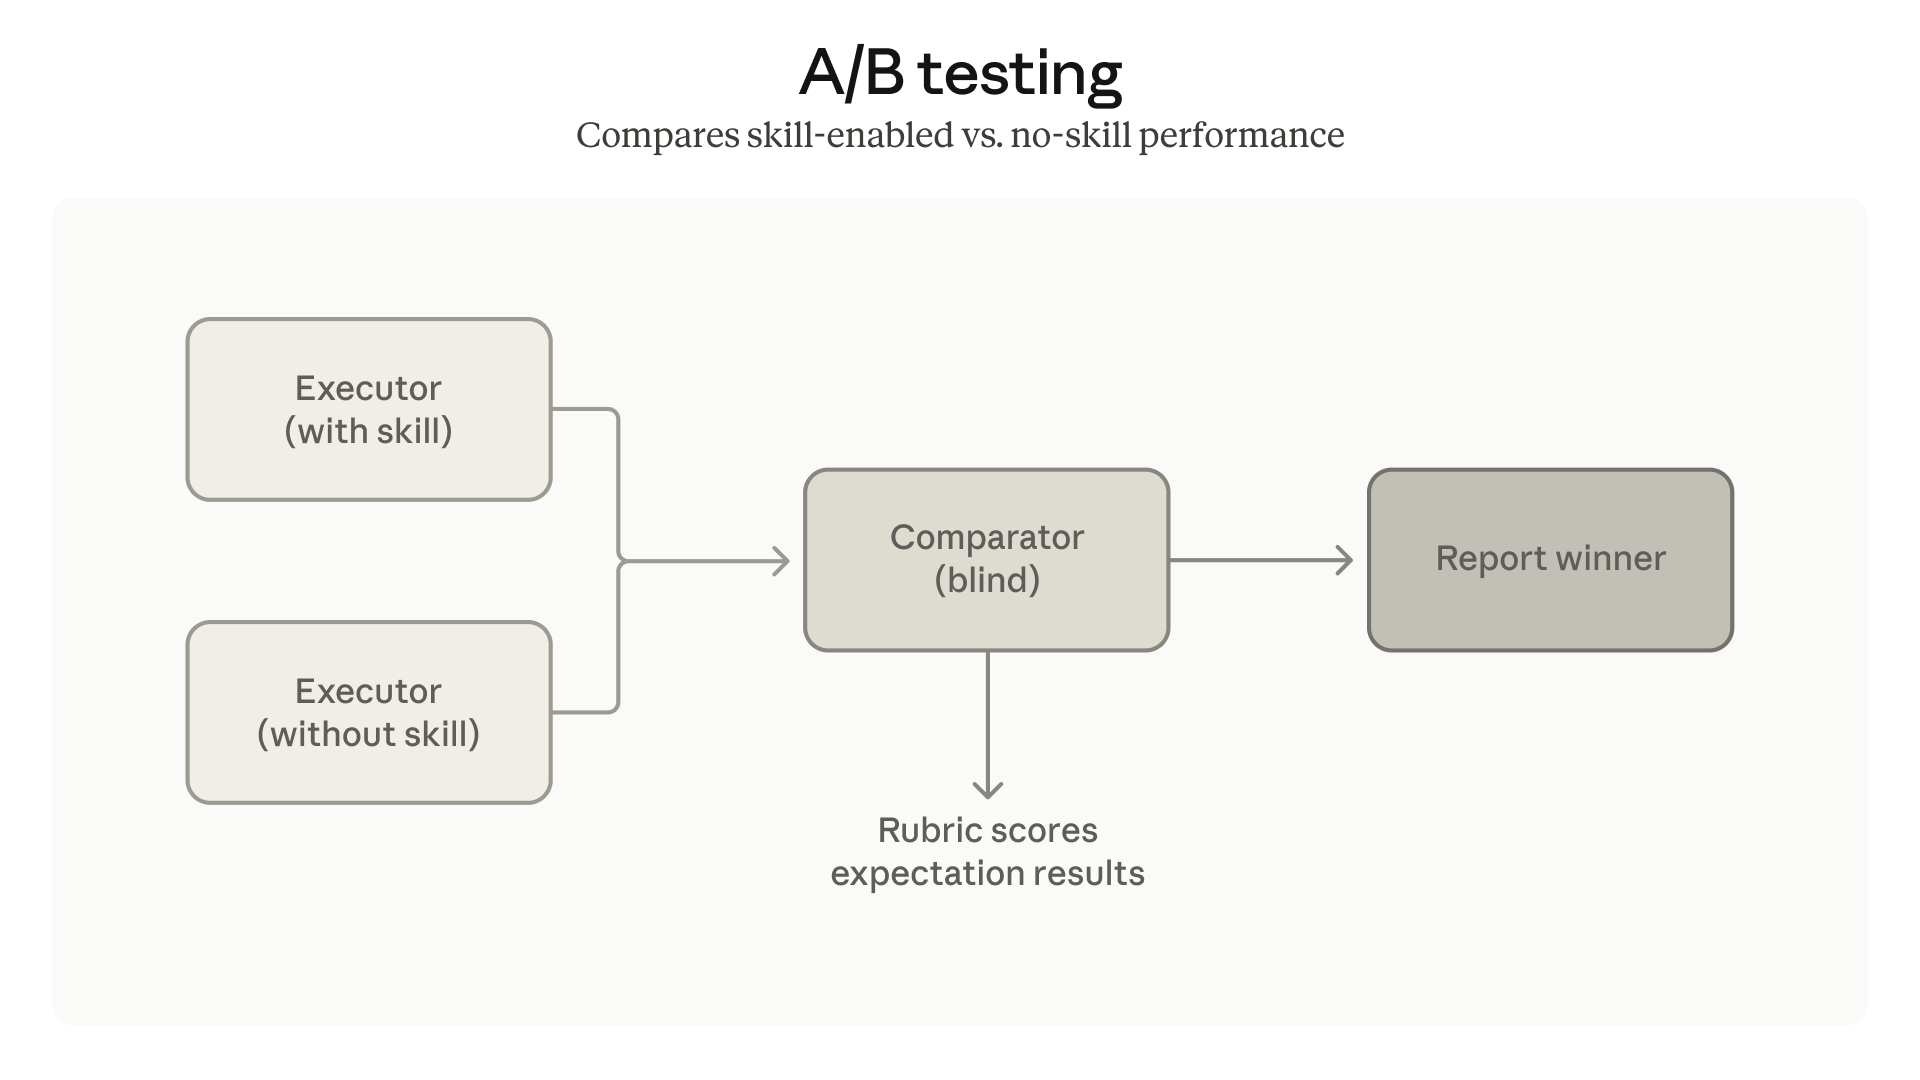
我们还加入了用于 A/B 比较的 comparator agents:可以比较两个 Skill 版本,或比较“有 Skill”和“无 Skill”。它们在不知道哪个输出来自哪个版本的情况下做判断,因此你能看出修改是否真的有帮助。
让 Skills 在正确时机触发
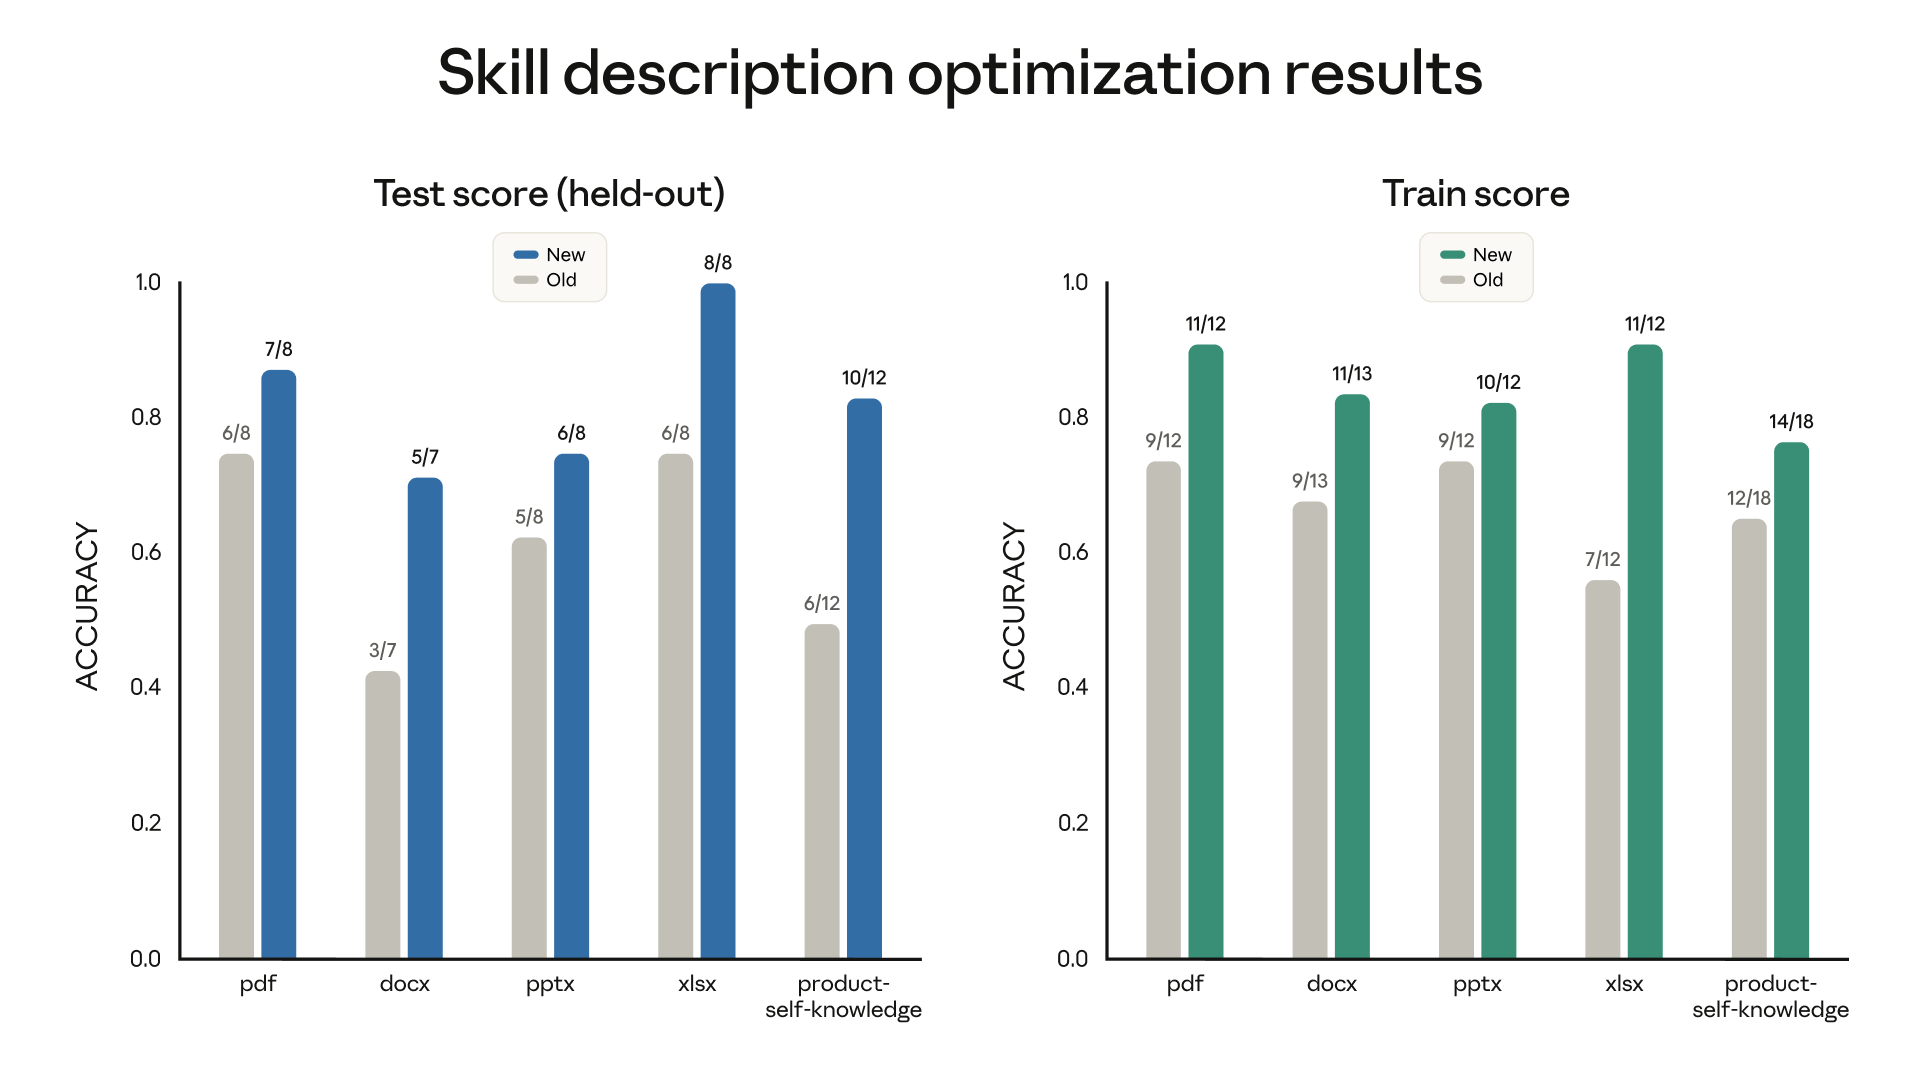
evals 衡量输出质量,但前提是 Skill 必须在该触发时触发。随着 Skill 数量增加,description 的精确性变得关键:太宽会误触发,太窄又不会触发。skill-creator 现在会根据示例 prompts 分析当前 description,并建议修改,减少误报和漏报。
我们在文档创建类 Skills 上试过,6 个公开 Skills 中有 5 个的触发效果得到改善。
展望未来
随着模型进步,“Skill”和“规格说明”之间的界限可能会变得模糊。今天,SKILL.md 本质上是一份实现计划,用详细指令告诉 Claude 如何做某件事。未来,也许只需要用自然语言描述 Skill 应该做什么,模型就能推导剩余部分。
今天发布的 eval 框架正是朝这个方向迈出的一步。evals 已经在描述“要做什么”。最终,这种描述本身可能就会成为 Skill。
开始使用
所有 skill-creator 更新现在都已在 Claude.ai 和 Cowork 可用。你可以让 Claude 使用 skill-creator 来开始。
Claude Code 用户可以安装插件,或从我们的 repo 下载。